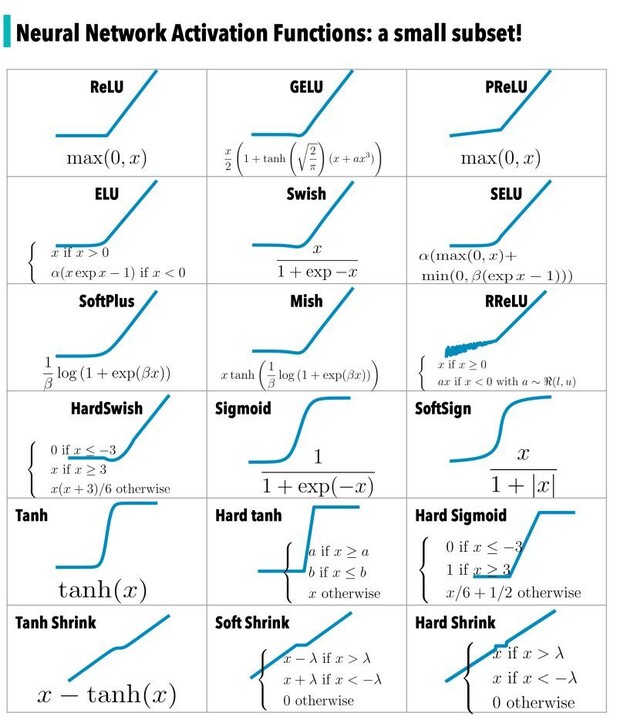
Activation function 이란
신경망의 선형 연산 결과를 비선형적으로 변환하여,
복잡한 함수 관계(비선형관계)를 학습할 수 있도록 하는 함수
DL에서 Activation Function은
- Linear Transformation의 출력에 비선형성(non-linearity)을 부여하여,
- 여러 layer를 쌓았을 때 단순한 하나의 Linear Transformation으로 축약되지 않고
- 복잡한 함수와 feature representation을 학습할 수 있도록 해주는 핵심 요소임
어떤 Activation Function을 쓰느냐에 따라 영향을 받는 건 다음과 같음:
- model의 표현력 :
- Activation Function이 non-linearity를 제공하여,
- model이 단순한 linear mapping을 넘어 복잡한 input-output 관계를 표현할 수 있도록 함.
- Optimization Dynamics :
- Activation Function의 미분 특성이 gradient flow에 직접 영향(chain rule에 의해 derivative가 반복적으로 곱해짐)을 주며,
- 이에 따라 parameter에 전달되는 gradient의 크기와 convergence speed가 달라짐.
- Training Stability :
- Activation Function의 출력 범위와 derivative 크기에 따라
- gradient가 지나치게 작아지거나 커질 수 있으며,
- 이는 vanishing gradient 또는 exploding gradient 문제와 관련됨.
- Weight Initialization Compatibility
- Activation Function마다 activation과 gradient의 variance를 안정적으로 유지하기 위한 조건이 다르므로,
- 이에 적합한 weight initialization 방식도 달라짐.
때문에 activation function의 type은 중요한 hyper-parameter로 다루어짐:
https://dsaint31.me/mkdocs_site/ML/ch08/dl_hyperparameters/?h=hyper#activation-function
BME
Activation Function Batch Size Deep Learning Hyperparameter Layer Neuron Optimizer Hyper-Parameters in DL Deep Learning에서 Hyper-parameter는 model이 **학습(training)을 통해 training dataset으로부터 자동으로 결정**하는 값(= parameter)
dsaint31.me
현재는 전통적인 sigmoid, tanh보다 gradient flow가 유리한 ReLU 계열 이 많이 사용됨:
- CNN에서는 ReLU(2010)와 SiLU (2016, 2017)가 널리 쓰이며,
- Transformer 계열에서는 GELU(2016)와 SwiGLU(2020) 같은 gated activation이 자주 사용되는 추세임.
등장년도
- ReLU: 2010
- Leaky ReLU: 2013
- PReLU: 2015
- RReLU: 2015
- ELU: 2015
- GELU: 2016
- SiLU: 2016, 2017
- SELU: 2017
- Swish: 2017
- Mish: 2019
- SwiGLU: 2020
DNN의 Vanishing/Exploding Gradient Problem을 완화하기 위해선 적절한 weight initialization과 같이 쓰여야 함:
https://dsaint31.me/mkdocs_site/ML/ch09/weight_initializations/
BME
Glorot initialization He initialization Kaiming initialization LeCun initialization Xavier initialization activation function fan in fan out gradient exploding gradient vanishing variance weight initialization Weight Initialization (가중치 초기화) We
dsaint31.me
종류
Step Function (Heaviside Step Function)
입력값이 threshold(임계값)을 넘는지에 따라 출력값을 0 또는 1로 결정하는 불연속 함수
https://dsaint31.tistory.com/553
[SS] Unit Step Function (Heaviside Step Function)
수식$$u(t)=\left\{\begin{matrix}1,& t>0 \\0, &t$t=0$인 경우의 값은 일반적으로 $\frac{1}{2}$를 취함항상은 아니며, $t=0$일 때, $1$을 가지는 경우도 많음.계단 모양이라는데에서 step이라는 이름이 붙음. Unit Step
dsaint31.tistory.com
Logistic Function (or Sigmoid Function)
입력값을 0과 1 사이의 연속적인 값으로 변환하여 확률적 해석이 가능하도록 하는 S자 형태의 비선형 함수.
- Sigmoid는 S자 형태를 가지는 함수들을 지칭하는 용어로, Logistic Function도 Sigmoid에 속함.
- DL분야에선 Logistic function을 Sigmoid라고도 많이 부름.
https://dsaint31.tistory.com/320
[ML] Logit에서 Logistic Function.
Logistic FunctionLogistic function은일종의 연속변수에 해당하는 "raw score"(정확히는 logit score)을 probability로 바꾸어주는 함수임: output이 0에서 1사이의 real number.미분가능!더보기Binary classification에서 True
dsaint31.tistory.com
https://dsaint31.tistory.com/430
[Math] Sigmoid function
S자형 곡선을 갖는 함수. (대표적인 예가 logistic function이나 sigmoid는 다음과 같이 여러 종류가 있음) Artificial Neural Network의 Artificial Neuron의 Activation function으로 초창기에 많이 사용되었음.Logistic dis
dsaint31.tistory.com
출력이 vector로 일반화한 softmax 도 존재하나,
이는 최종 layer의 output function으로 사용되지, interemediate layers의 activation으로는 사용되지 않음.
https://dsaint31.tistory.com/294
[ML] Softmax function
Softmax 함수란?ML 에서 multiclass classification을 수행하는 모델의 최종 output을 출력하는 activation함수로 사용되는 함수.Softmax regression (=multinomial logistic regression)에서 사용됨.Logistic Function의 Generalization
dsaint31.tistory.com
tanh Function
입력값을 −1 과 1 사이의 연속적인 값으로 변환하는 S자 형태의 비선형 activation function.
RNN등에서 많이 사용되었고, 이 역시 Sigmoid에 속함.
https://dsaint31.tistory.com/577
[DL] Hyperbolic Tangent Function (tanh)
logistic function과 함께 sigmoid의 대표적인 함수가 바로 $\text{tanh}$임.값이 $[-1,1]$의 range를 가지며, logistic에 비해 기울기가 보다 급격하기 때문에 좀 더 빠른 수렴속도를 보임.하지만, sigmoid의 일종이
dsaint31.tistory.com
Softsign Function
입력값을 −1과 1 사이의 연속적인 값으로 부드럽게 변환하는 비선형 activation function 으로
tanh 의 대체품으로 많이 사용되며 이 역시 Sigmoid에 속함.
https://dsaint31.tistory.com/581
[DL] Softsign : tanh의 유사품
hyperbolic tangent (=tanh)와 유사한 함수. tanh 대신 activation function으로 사용되는 경우도 있음. $$\text{softsign}(x)=\frac{x}{1+|x|}$$ softsign의 derivative는 다음과 같음. $$\dfrac{d}{dx}\text{softsign}(x)=\dfrac{1}{\left(1+|x|\
dsaint31.tistory.com
ReLU (Rectified Linear Unit)
입력값이 0보다 작으면 0으로, 0 이상이면 입력값 그대로 출력하는 가장 대표적인 비선형 activation function
다른 분야에서 Ramp Function이라고도 불림: Vanishing Gradient Problem에 강한 Activation Function
https://dsaint31.me/mkdocs_site/ML/ch09/act_relu/
BME
Activation Function He Initialization Leaky ReLU PReLU RReLU ReLU Rectified Linear Unit (ReLU) ReLU는 다른 분야에서는 Ramp Function이라고도 불림. 초기 perceptron의 Unit step에서 logistic 으로 activation function으로 바꾸어진 이
dsaint31.me
https://dsaint31.tistory.com/556
[SS] Ramp Function
수식$$ r(t)=\left\{\begin{matrix} t, & t\ge 0\\ 0, & tramp 는 말 그대로 경사로 같이 생겼기 때문에 유래된 이름임. waveform참고ramp 는 unit step 의 integration에 해당함.$$\begin{aligned} r(t)&=\int_{-\infty}^t u(\tau)d\tau \\
dsaint31.tistory.com
Leaky ReLU
음의 입력값에도 작은 기울기를 유지하여 0이 아닌 작은 값을 출력하는 ReLU의 변형인 비선형 activation function
https://dsaint31.me/mkdocs_site/ML/ch09/act_relu/#leaky-relu
BME
Activation Function He Initialization Leaky ReLU PReLU RReLU ReLU Rectified Linear Unit (ReLU) ReLU는 다른 분야에서는 Ramp Function이라고도 불림. 초기 perceptron의 Unit step에서 logistic 으로 activation function으로 바꾸어진 이
dsaint31.me
Parametric Leaky ReLU (PReLU) and Randomized ReLU (RReLU)
- 2015
- Parametric Leaky ReLU (PReLU) : 음의 입력에 적용되는 기울기 α를 학습 가능한 파라미터로 두어 데이터에 맞게 조정하는 Leaky ReLU의 변형
- Randomized ReLU (RReLU)는 음의 입력에 적용되는 기울기 α를 일정 범위에서 무작위로 선택하여 학습 시 사용하는 ReLU의 변형으로, 일종의 regularization 효과를 가짐.
BME
Activation Function He Initialization Leaky ReLU PReLU RReLU ReLU Rectified Linear Unit (ReLU) ReLU는 다른 분야에서는 Ramp Function이라고도 불림. 초기 perceptron의 Unit step에서 logistic 으로 activation function으로 바꾸어진 이
dsaint31.me
Exponential Linear Unit (ELU)
음의 입력에는 지수함수를 적용하고 양의 입력에는 입력값을 그대로 출력하여,
음의 영역에서도 smooth한 비선형성을 제공하는 activation function (2015)
https://dsaint31.me/mkdocs_site/ML/ch09/act_elu/
BME
Exponential Linear Unit (ELU) The variants of ReLU 의 성공에도 불구하고, 이들의 discontinuity로 인한 slow converge나 gradient descent bounce 등의 단점이 해결되지 못함. 이를 해결하기위해 softplus, ELU(2015), and SELU(2017)
dsaint31.me
Scaled ELU (SELU)
ELU에 특정 scaling factor를 적용하여
각 층의 출력이 평균 0, 분산 1에 가까워지도록 자기 정규화(self-normalizing)를 유도하는 activation function (2017)
https://dsaint31.me/mkdocs_site/ML/ch09/act_elu/#scaled-elu-selu
BME
Exponential Linear Unit (ELU) The variants of ReLU 의 성공에도 불구하고, 이들의 discontinuity로 인한 slow converge나 gradient descent bounce 등의 단점이 해결되지 못함. 이를 해결하기위해 softplus, ELU(2015), and SELU(2017)
dsaint31.me
Gaussian Error Linear Unit (GELU)
GELU는 input을 Gaussian distribution에 기반한 확률적 weighting으로
부드럽게 gating하는 smooth activation function (2016).
BME
activation function deep learning gelu glu mish relu silu swish Sigmoid Linear Unit (SiLU) : from GELU to MiSH SiLU 는 Sigmoid Linear Unit 의 약자로 ELU (2015) 이후 2016년에 등장한 smooth activation function 계열 중 하나로, 여러 실험
dsaint31.me
Sigmoid Linear Unit (SiLU) and Swish
SiLU는 input에 sigmoid를 곱하는 smooth, non-monotonic activation function이며,
Swish의 β=1인 경우와 동일함 (2016, 2017).
Swish는 input을 sigmoid gate와 곱하여 부드러운 비선형성을 제공하고 gradient flow를 개선하는 activation function (2017)
https://dsaint31.me/mkdocs_site/ML/ch09/act_silu/
BME
activation function deep learning gelu glu mish relu silu swish Sigmoid Linear Unit (SiLU) : from GELU to MiSH SiLU 는 Sigmoid Linear Unit 의 약자로 ELU (2015) 이후 2016년에 등장한 smooth activation function 계열 중 하나로, 여러 실험
dsaint31.me
Mish
Mish는 Softplus와 tanh를 결합하여 smooth하고 non-monotonic한 특성을 가지도록 설계된 activation function (2019)
https://dsaint31.me/mkdocs_site/ML/ch09/act_silu/#mish
BME
activation function deep learning gelu glu mish relu silu swish Sigmoid Linear Unit (SiLU) : from GELU to MiSH SiLU 는 Sigmoid Linear Unit 의 약자로 ELU (2015) 이후 2016년에 등장한 smooth activation function 계열 중 하나로, 여러 실험
dsaint31.me
Swish Gated Linear Unit (SwiGLU)
SwiGLU는 Activation Function이라기보다는
두 Linear Transformation 중 하나에 SiLU(Swish)를 적용한 뒤
다른 하나와 element-wise multiplication하여 gating을 수행하는 activation mechanism임 (2020)
https://dsaint31.tistory.com/980
SwiGLU (Swish-Gated Linear Unit)
참고: Swish 란Swish와 SwiGLU는 서로 다른 개념임. Swish는 하나의 activation function임:$$\operatorname{Swish}(x)=x\sigma(x)$$여기서 $\sigma(x)$는 sigmoid 함수임.즉, 입력 $x$에 sigmoid를 곱하여 입력의 크기를 조절하는
dsaint31.tistory.com
'ML' 카테고리의 다른 글
| [EX] 이상기체상태방정식 모델: ANN (0) | 2026.09.27 |
|---|---|
| Google Colab VS Code Extension (0) | 2026.09.20 |
| [PyTorch] Matrix Multiplication (0) | 2026.09.16 |
| ICL, Prompting, and CoT (0) | 2026.09.03 |
| [DL] Dataset: ImageNet과 ILSVLC (0) | 2026.08.27 |


